2026年10月28日上午,由阐释与国际传播研究院主办的学术讲座在白云山校区科研楼一楼会议室举行。讲座由陈开举教授主持,北京科技大学外国语学院教授、博士生导师、翻译学科带头人、当代语言科学研究中心主任赵秋荣教授主讲,主题为“语料库标注:理论规范、方法拓展与智能化实践”。
讲座伊始,赵秋荣教授指出,语料库标注不是文本收集后的附属工序,而是连接语言学理论、研究问题与可计算数据的关键环节,其核心在于把理论概念转化为可操作的标注单位、标签类别与判定规则。围绕“语言学理论如何转化为可操作的标注体系”“语料标注的可靠性如何建立”“大语言模型将如何改变语料库研究范式”等问题,赵秋荣教授将语料库翻译学研究概括为“建设—标注—提取—分析”四阶段流程,强调研究问题驱动、方法贯穿、数据质量控制与结果可复现。她以政府工作报告英文文本中的被动语态识别为例指出,关键词命中不等于被动结构识别,自动初筛也不等于最终统计,需结合词性标注、正则检索与人工复核;又以《边城》汉英对照语料为例说明,汉英被动表达的形式差异不等于意义与翻译关系的完全对应,标注单位、类别边界与对齐规则必须事先明确。
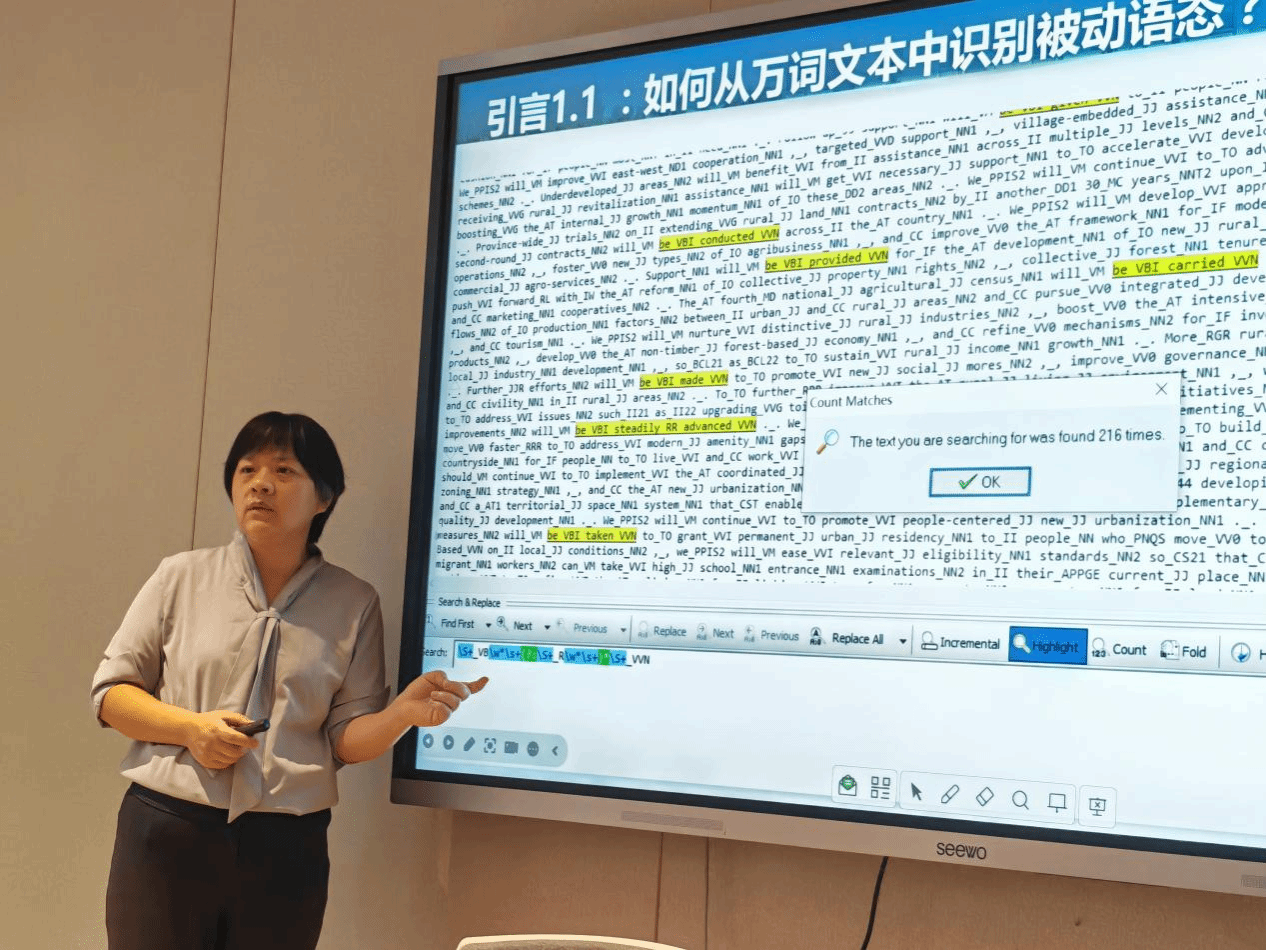
赵秋荣主讲“语料库标注:理论规范、方法拓展与智能化实践”
随后,赵秋荣教授系统讨论了语料标注可靠性的评估框架。她区分一致性、可靠性与有效性三个层面:一致性关注不同标注结果在多大程度上相同,可靠性关注同一规范在重复、换人或换运行时能否稳定复现,有效性则追问标注是否真正测量了所关注的语言学概念。她指出,观察一致率高并不必然意味着标注可靠,必须考虑机会一致率与类别分布,合理选择Cohen's kappa、Scott's pi、Fleiss' kappa、Krippendorff's alpha等指标;人工标注与大模型标注都应锁定标注单位、标签定义和边界规则,保留原始输出,报告混淆矩阵、低频类别分歧与跨运行一致性,避免“哪个系数高就选哪个”。结合多模态图像标注、AI生成摘要泛化标注、元话语标注、可选连词that/Ø标注及《春蚕》人机翻译依存关系标注等案例,赵秋荣教授展示了传统语言学标注向翻译关系标注、多模态标注和句法关系标注拓展的操作路径,并指出大语言模型可辅助完成规则执行、批量分类与初步筛查,但模型版本、提示词、温度、输出模板与运行日期必须进入元数据,正式标注前需以人工金标准进行预评估,正式标注后还需分层抽样后验验证。
同时,赵秋荣教授也指出,大语言模型改变了标注工作的分工方式,却没有取消人的判断责任。提示词设计与规则细化、边界案例仲裁、标注有效性检验和结果解释仍需要研究者承担;模型输出“稳定”并不等于“正确”,指令遵循能力与语域忠实度、标注一致性并不必然同步。智能化标注的适用边界在于:让人工工作集中在前期规则设计、金标准建立与后期验证环节,让模型在透明、可追踪的条件下处理大规模语料,从而使语料库标注从“获得工具”走向“理解、研究与善用工具”。
讲座现场
在讲座最后,陈开举教授总结道,今天的讲座为我们带来了一场兼具方法规范与前沿视野的学术盛宴,从语料库标注的理论操作化到一致性、可靠性与有效性的质量评估,从被动语态、汉英被动表达对齐到多模态、元话语、that/Ø与依存关系标注,再到大语言模型辅助标注的人机协同路径,为我们搭建了理解智能时代语料库翻译研究标注体系的完整认知框架。随后,师生们就讲座主题进行了热烈讨论,赵秋荣教授都一一耐心解答。期盼未来有更多这样深刻的学术交流,为语料库语言学、翻译学与语言智能研究贡献更多智慧。

