2026年10月27日上午,由阐释与国际传播研究院主办的学术讲座在白云山校区科研楼一楼会议室举行。讲座由陈开举教授主持,北京科技大学外国语学院教授、博士生导师、翻译学科带头人、当代语言科学研究中心主任赵秋荣教授主讲,主题为“从 Brown 到 AI-Brown:语料库建设的传承与创新”。
讲座伊始,赵秋荣教授指出,大模型时代语料库建设与研究并非失去价值,而是面临研究设计、数据治理与可复现性的更高要求。语料库建设不是文本堆积,而是可论证的研究设计;Brown语料库的科学抽样传统,其核心正在于代表性、平衡性、可比性与可复现性。AI-Brown不是“随机收集AI文章”,而是以同一原文起点构造人类续文与模型续文的可比关系,继承的是“可比较的研究设计”。
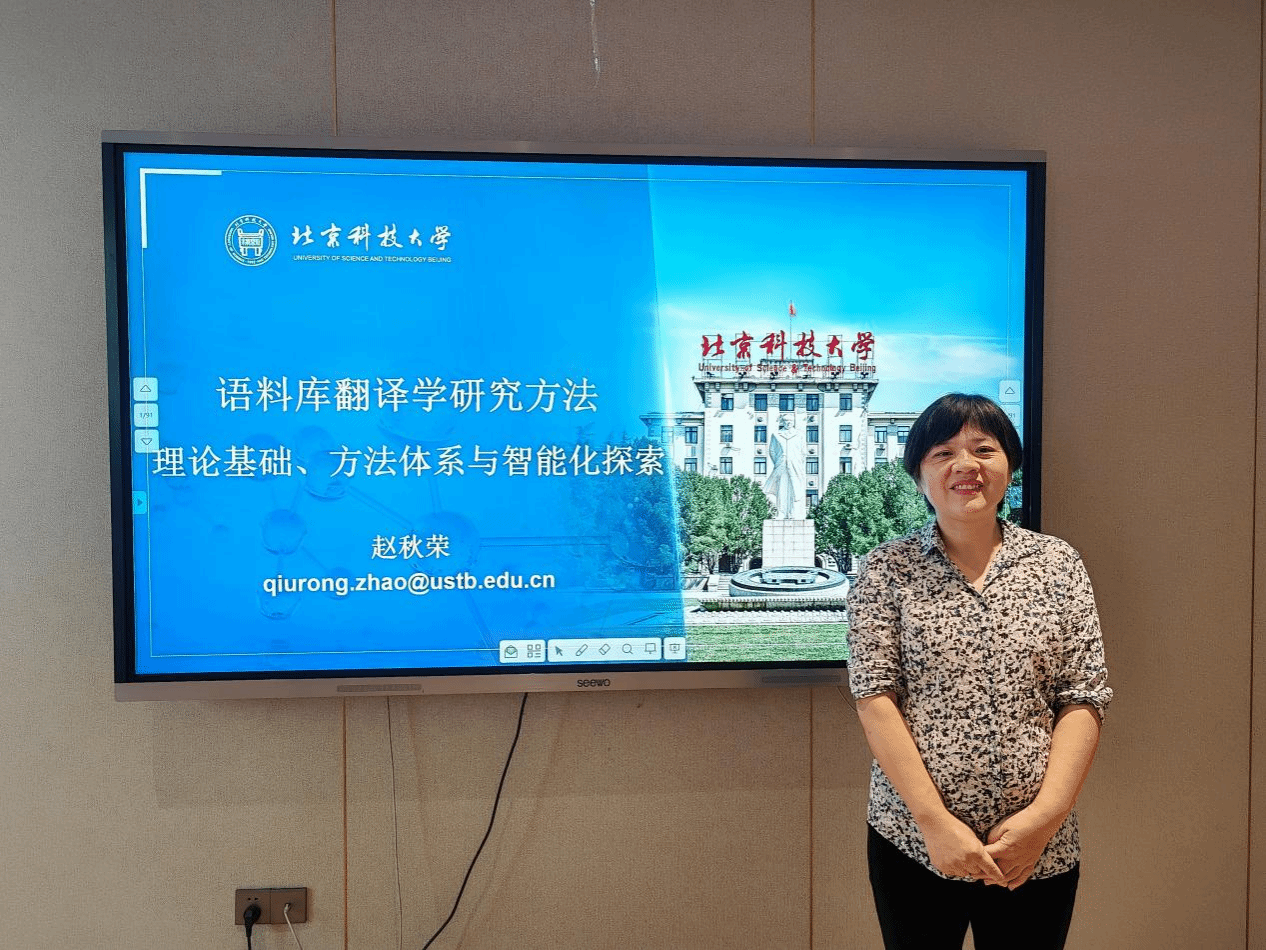
赵秋荣主讲“从 Brown 到 AI-Brown:语料库建设的传承与创新”
随后,赵秋荣教授以Brown语料库及其历时、跨地域和跨语言扩展为线索,梳理了Brown家族语料库的发展脉络,包括Brown、Frown、Crown、LOB、FLOB、CLOB等,以及LCMC、ZCTC、ToRCH2014等汉语语料库建设实践。赵秋荣教授将语料库翻译学研究概括为“建设—标注—提取—分析”四阶段流程,并提出语料库建设需回答来源、选材、时段、体裁、目标总体和研究问题等六个设计问题。赵秋荣教授指出,Brown抽样范式从英语地域变体扩展到现代汉语和翻译汉语,关键不是机械复制体裁名称,而是复制抽样逻辑、实现文化功能适配;相关研究还发现翻译汉语词汇密度较低、连接词使用更显化、句法复杂度在不同维度和体裁上呈现双向差异。
在AI-Brown案例中,赵秋荣教授重点讨论了当文本生产者变成大语言模型后,经典语料库设计如何继续使用。AI-Brown以BE21为人类参照,继承Brown家族多语域书面文本的可比性框架,以真实文本前500词作为上下文输入,由大语言模型续写,并保留人类原文后续部分作为对照,同时记录模型、提示词、温度等生成条件。赵秋荣教授还介绍了捷克语AI-Koditex的建设经验,指出英语采用Biber六维分析框架、捷克语采用Cvrček等八维分析框架,两套语料既采用相似建设方法,又尊重各自语言特点。研究发现,AI语言存在共同偏移倾向,但并非统一的“AI文体”;不同模型偏移幅度不一致,模型语域再现能力不能简单依据模型新旧或规模判断,部分基础模型能够较好保留原文语言特征,而指令微调未必提升语域忠实度;英语与捷克语之间存在明显语域再现差距,生成条件必须进入语料库元数据。
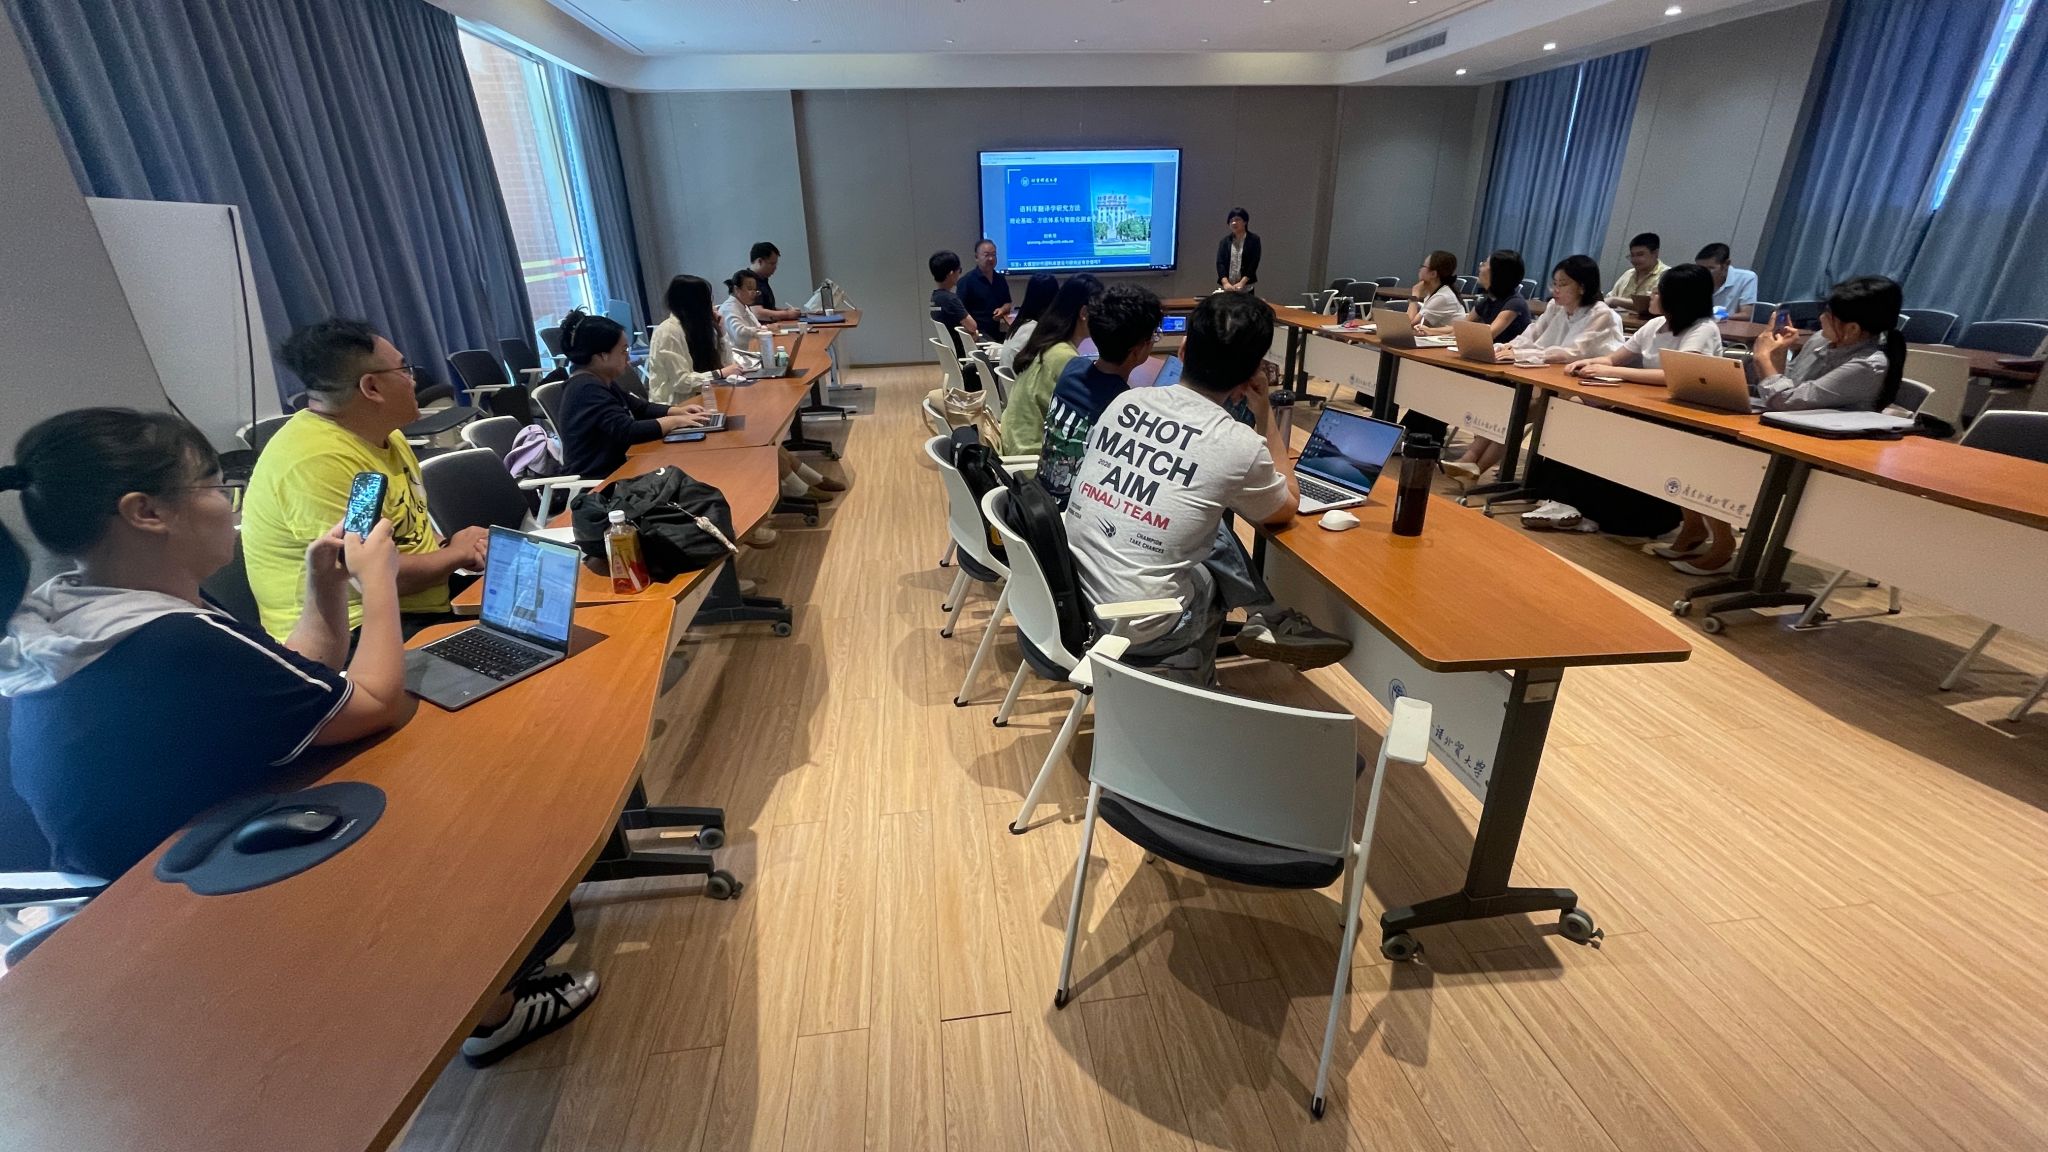
讲座现场
在研究案例部分,赵秋荣教授以“提示语能否调节大语言模型的句法生成”为例,介绍了以500篇中文原文为共同来源、包含人工翻译与三种提示语译文、约417万词的平行翻译语料库,并采用平均依存距离和平均层级距离两项指标,结合混合效应模型考察提示语与语域的交互作用。赵秋荣教授指出,提示语能够调节句法组织,但调整方向因语域而异;更详细的任务说明未带来一致的复杂度增加;提示语调整也未呈现全面趋近人工译文的趋势。稳健性检验表明,总体交互模式获得支持,但控制句长后部分结论依赖解析器,相关解释需保持边界清晰。
最后,赵秋荣教授介绍了LancsBox X、Sketch Engine等平台在语料库建设与分析中的应用,强调从“获得工具”走向“理解、研究与善用工具”。赵秋荣教授指出,AI已进入语言选择与研究过程本身,拓展了译者行为研究的对象,但没有取消人类对判断、规范与责任的承担;语料库研究需在理论操作化、质量评估、统计建模与智能反思之间形成闭环。
在讲座最后,陈开举教授总结道,今天的讲座为我们带来了一场兼具方法论深度与前沿视野的学术盛宴,从Brown语料库的科学抽样传统到AI-Brown的可比性设计,从语料库翻译学的四阶段流程到提示语句法研究案例,为我们搭建了理解智能时代语料库建设与翻译研究的完整认知框架。随后,师生们就讲座主题进行了热烈讨论,赵秋荣教授都一一耐心解答。期盼未来有更多这样深刻的学术交流,为数字时代语料库语言学、翻译学与语言智能研究贡献更多智慧。

